匿名的访客识别适用于 Shopify: 最终的指南
了解如何匿名的访客识别适用于 Shopify 工作原理. 大师服务器端追踪,隐私合规,送达率保护,和 Klaviyo 工作流.
相关文章
要点
- 要理解访客识别为何能迅速普及,首先必须了解现代电商品牌所面临的财务压力。
- Shopify的匿名访客识别核心在于将原始会话标记——如IP地址、设备用户代理和浏览器特征——转化为经过认证的个人级联系资料。
- 传统追踪依赖于直接在访客浏览器中执行的客户端JavaScript标签。
- 当匿名会话被路由到身份解析引擎时,软件会将会话的技术标记与身份图谱进行比对。
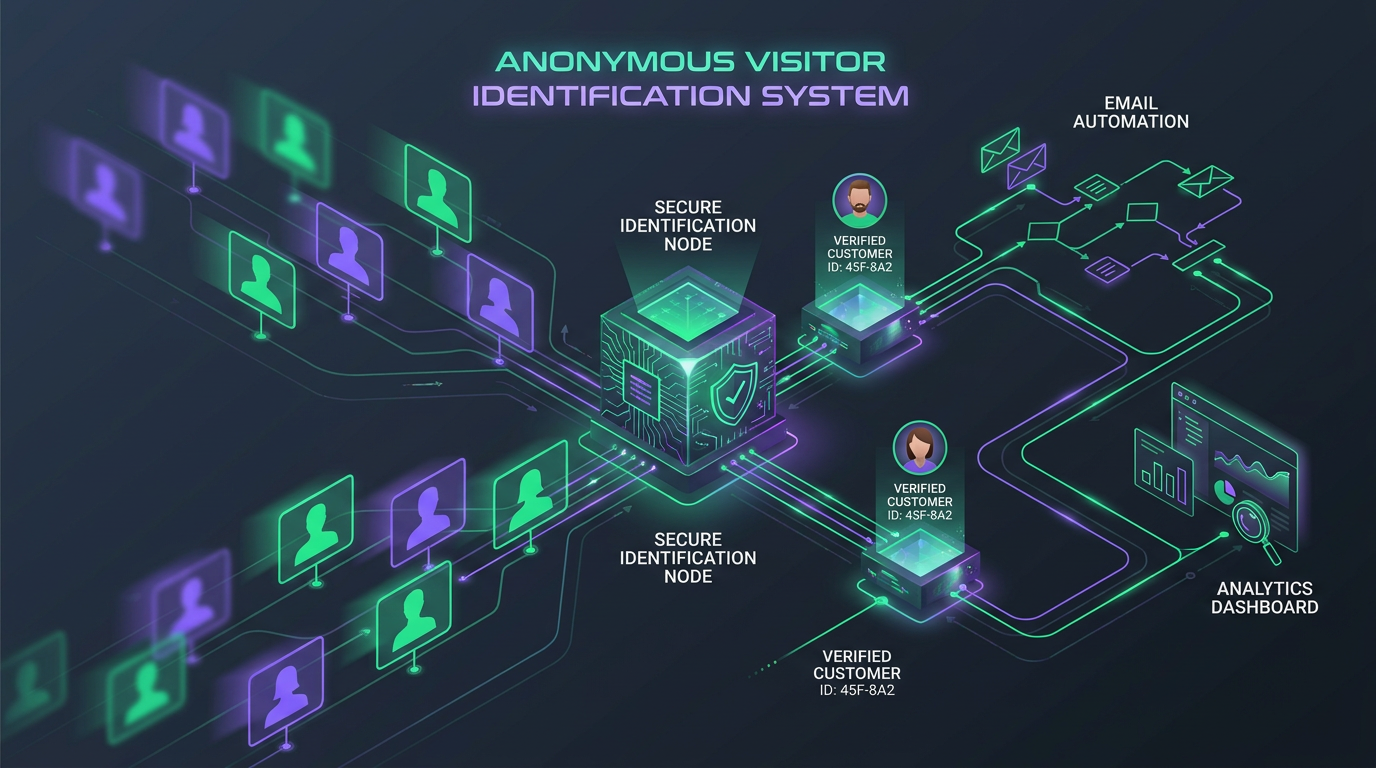
每天,成千上万具有高购买意向的购物者访问在线店铺,浏览产品系列,将商品加入购物车,却在未留下任何痕迹的情况下离开。对于普通的Shopify商家来说,直销(DTC)的转化率通常仅在1.17%至2.2%之间。这意味着约98%的付费和自然流量以完全匿名的状态离开店铺,随之带走了广告支出的效率和潜在收入。
针对这一持续的流失问题,Shopify匿名访客识别已成为以增长为导向的DTC品牌的关键策略。通过连接网站会话活动与个人级身份图,身份解析技术使店主能够通过定向电子邮件自动化和付费社交受众重新激活未订阅的浏览放弃者。
然而,部署身份解析并非简单地将客户端JavaScript标签粘贴到店铺。应对浏览器隐私更新带来的信号丢失,遵守GDPR和CCPA等严格地区法规,并保护电子邮件送达率,都需要明确的运营策略。本指南详细解析了在Shopify上有效实施访客识别所需的技术机制、合规协议、送达防护及工作流设置。
匿名流量危机与信号丢失
要理解访客识别为何迅速普及,首先需关注现代电商品牌面临的财务压力。根据Baymard Institute(2026)汇编的电商研究,平均在线购物车放弃率为70.22%,移动端购物车放弃率超过80%。结合漏斗顶部着陆页的高跳出率,绝大多数营销预算都花费在驱动从未创建账户或填写弹窗表单的流量上。
+-----------------------------------------------------------------------+
|                       匿名流量缺口                                   |
+-----------------------------------------------------------------------+
|  网站总访客量:100%                                                  |
|  |-- 转化客户:约2.0%                                                |
|  |-- 已知订阅者(列表中):约8.0%                                   |
|  \-- 匿名流失访客:约90.0%                                          |
|      |-- 传统Cookie重定向(被ITP/广告拦截器阻断)                   |
|      \-- 现代服务器端身份解析(匹配率25% - 45%)                     |
+-----------------------------------------------------------------------+
历史上,绩效营销人员依赖广告网络的第三方跟踪像素来重定向这些匿名会话。但浏览器架构的结构性变化严重限制了这些客户端机制:
Apple Safari ITP(智能跟踪防护):将通过客户端脚本设置的第一方Cookie的有效期限制为最多7天或24小时。
广告拦截器和隐私浏览器:如Brave浏览器及uBlock Origin扩展积极阻断第三方跟踪脚本,导致客户端数据流减少30%至40%。
第三方Cookie的废弃:主流浏览器引擎持续限制跨站跟踪路径,迫使品牌完全依赖第一方数据采集。
随着Meta和Google Ads等平台的客户获取成本(CAC)上升,流失近98%的店铺流量成为严重的增长瓶颈。为挽回流失收入,品牌必须采用能够直接在第一方层面捕获高意向会话信号的基础设施。
技术架构:身份解析的工作原理
本质上,Shopify匿名访客识别将原始会话标记(如IP地址、设备用户代理和浏览器特征)转换为经过认证的个人级联系档案。要在不降低网站速度或被浏览器隐私控制阻断的情况下实现这一点,需依赖强大的服务器端架构。
客户端像素与服务器端第一方基础设施
传统跟踪依赖于直接在访客浏览器中执行的客户端JavaScript标签。当用户访问Shopify页面时,客户端浏览器尝试连接第三方域以传输事件数据。现代浏览器隐私引擎会迅速识别并阻断这些第三方请求。
相比之下,现代身份解析基础设施采用自定义CNAME DNS代理。通过将跟踪信号路由至自定义子域(如data.yourstore.com),识别脚本严格在原生第一方上下文中运行。此自定义设置带来显著运营优势:
绕过广告拦截器:由于网络请求源自并指向商家自有域名,网络级广告拦截器不会自动标记或屏蔽跟踪脚本。
延长Cookie寿命:通过服务器端DNS响应设置的第一方Cookie可抵抗Safari ITP截断,保持更长的会话历史。
服务器到服务器事件管道:如查看产品变体或加入购物车等意向事件,直接从商家服务器或Shopify后端流向广告端点,使用Meta Conversions API(CAPI)等工具,确保信号完整传输。
对于希望将会话识别与点击后营销绩效关联的店主,平台如Attribuly结合服务器端第一方事件跟踪与多触点归因模型,帮助确保每个去匿名化会话准确追溯至其初始获取渠道。
确定性与概率性身份匹配
当匿名会话被路由至身份解析引擎时,软件会将会话技术标记与身份图进行比对。身份图通过两种主要方法聚合数据:
确定性匹配(个人级):该方法将访客信号与预先同意的第一方数据网络匹配,这些网络以通过SHA-256哈希的电子邮件地址(HEMs)和移动广告ID(MAIDs)为锚点。由于依赖确定性登录事件的精确字符串匹配,个人级准确率接近100%。这种高准确率使确定性数据成为触发个性化电子邮件活动的关键。
概率性匹配(统计学):该方法利用统计算法、IP聚类和位置元数据推断访客可能属于特定家庭或人口画像。虽然适合广泛的漏斗顶部广告定位,但概率性匹配误差率较高。使用概率性联系人进行直接电子邮件营销常导致收件人困惑、高垃圾邮件投诉率及发件人声誉受损。
对于DTC电商品牌,美国流量的现实确定性匹配率通常介于25%至45%之间。声称匹配率超过70%通常依赖更广泛的家庭级概率数据,若用于直接营销则可能带来显著送达风险。
法律与隐私合规框架:美国与欧盟协议对比
部署身份解析工具需严格遵守地区隐私法规。全球市场的隐私合规要求不尽相同,忽视地区法律边界可能导致严厉的监管罚款和品牌损害。
法规 / 指标 | 美国框架(CCPA / CPRA / CAN-SPAM) | 欧盟框架(GDPR / ePrivacy指令) |
|---|---|---|
主要法律机制 | 选择退出模式(“通知并明确选择退出”) | 严格选择加入模式(“事先明确同意”) |
第一方脚本加载 | 默认允许,前提是显示清晰的隐私通知。 | 非必要跟踪脚本必须在用户同意前被阻止。 |
电子邮件推广规则 | 商业推广允许,需遵守CAN-SPAM要求并提供退订链接。 | 商业营销邮件需根据第6条获得明确事先同意。 |
消费者权利 | 需提供功能性“禁止出售或共享我的信息”链接。 | 强制执行被遗忘权删除及完整数据访问权。 |
Shopify店铺的运营地理围栏
为确保完全合规,Shopify商家应在标签管理设置中实施自动化地理围栏逻辑:
IP地理围栏:自动屏蔽来自欧盟(EU)、欧洲经济区(EEA)或英国(UK)会话的访客识别脚本,除非通过GDPR合规的Cookie同意横幅记录了有效同意。
更新隐私披露:确保店铺隐私政策明确披露使用第一方数据采集工具以个性化客户体验和支持营销活动。
自动化选择退出同步:确保用户点击店铺页脚的“禁止出售或共享我的个人信息”时,立即向身份提供商发送选择退出信号,停止该会话的识别。
欲深入了解如何在兼顾隐私要求的同时提升店铺销售,请参阅本指南,了解如何将匿名访客转化为收入。
送达防护手册:保护ESP健康
向通过身份解析识别的联系人发送自动化邮件,根本不同于向活跃的新闻订阅者发送邮件。由于这些联系人未在该会话期间明确输入电子邮件,电子邮件服务提供商(ESP)如Klaviyo及主要邮箱提供商(Google、Yahoo)会根据严格的送达标准评估这些邮件。
若无适当防护,向去匿名化档案自动发送邮件可能导致硬退信率飙升、触发垃圾邮件投诉,损害您的域名发送声誉。保护发件域名需遵循结构化的四部分送达框架。
+-----------------------------------------------------------------------+
|                    送达保护流程                                       |
+-----------------------------------------------------------------------+
|  去匿名化联系人档案捕获                                               |
|  `--> 第1步:实时API清洗(语法、垃圾邮件陷阱、退信)                |
|  `--> 第2步:技术认证检查(SPF、DKIM、DMARC)                      |
|  `--> 第3步:智能抑制规则(排除买家/订阅者)                        |
|  `--> 第4步:专用暖域及逐步发送量提升                               |
|  `--> 第5步:注入定制Klaviyo软触达流程                             |
+-----------------------------------------------------------------------+
1. 强制技术认证
在向去匿名化地址发送任何邮件前,确认您的DNS认证记录已完全配置:
SPF(发件人策略框架):验证您的发送服务器IP地址被明确授权代表您的域发送邮件。
DKIM(域密钥识别邮件):为每封外发邮件附加加密签名,证明内容在传输过程中未被篡改。
DMARC(基于域的消息认证):将策略设置至少为
p=none或p=quarantine,确保邮箱提供商能验证SPF和DKIM签名的一致性。专用品牌发送域:避免使用共享ESP发送池。通过专用子域(如
mail.yourstore.com)路由自动识别流程,隔离并保护您的主企业域名声誉。
2. 实时API清洗与名单卫生
切勿将未经验证的身份图输出直接推送至活跃的电子邮件自动化流程。每个去匿名化的电子邮件地址都应通过实时验证API(如ZeroBounce或NeverBounce)过滤风险地址后再导入:
剔除Catch-All域:过滤与通用企业别名(
info@、sales@、admin@)相关的地址。消除无效语法和一次性邮箱:即时剔除格式错误或临时邮箱地址。
识别已知垃圾邮件陷阱:通过清洗被标记为活跃垃圾邮件陷阱或高频投诉者的地址,保护您的域名。
3. 逐步域名预热与发送量提升
若首次在某域激活访客识别,需限制每日发送量以建立发件人信任:
第1–5天:每日去匿名化自动发送限制在50至100封。
第6–10天:在开启率保持30%以上、垃圾邮件投诉率低于0.08%的前提下,将发送量提升至每日200–250封。
第11–20天:每日递增20%至30%发送量,同时密切监控发件人声誉指标。
4. 智能抑制规则
为避免打扰近期客户或导致受众疲劳,应在营销自动化平台内设置自动抑制规则。始终排除以下档案参与去匿名化识别流程:
过去30至60天内有下单记录的客户。
当前正在参与欢迎系列或购物车放弃流程的活跃订阅者。
已连续收到两封去匿名化邮件但未打开或点击的联系人。
步骤1:在Shopify上部署第一方数据采集
使用Shopify的Web Pixels API或自定义应用集成安装您的识别提供商第一方脚本。确保设置采用自定义CNAME DNS代理,使事件数据原生通过您的域名流转。
使用集成解决方案如Attribuly Capture,店主可在服务器端捕获匿名访客意向信号,同时将会话数据直接同步至底层归因报告。
步骤2:配置专用Klaviyo行为流程
不要将去匿名化联系人直接混入原生的表单填写Worked Browse Abandonment流程。这些原生流程针对已识别的订阅者设计,他们期待直接的后续消息。相反,应在Klaviyo内为去匿名化访客构建专用流程。
流程触发设置
指标触发:
De-Anonymized Session Captured(通过自定义API直接推送)。流程过滤器:
过去30天内下单次数为零且过去30天内未进入此流程且不在主营销名单中。
[ 匿名访客浏览产品 ]
                |
                v
[ 服务器端第一方采集(CNAME代理) ]
                |
                v
[ 确定性图谱匹配 + 实时验证 ]
                |
                v
[ 访客是否已为订阅者/买家? ]
       /                                \
     是                                 否
     /                                    \
[ 抑制流程 ]            [ 通过智能过滤 ]
                                          |
                                          v
                         [ 触发Klaviyo软触达流程 ]
                         |-- 邮件1(2-4小时):实用指南 / 热销产品
                         \-- 邮件2(24-48小时):社交证明 / 价值展示
消息节奏与文案策略
由于这些收件人在最近会话中未明确填写弹窗表单,避免使用诸如“我们看到您正在查看此商品!”等强推销文案。此类方式可能令人反感,导致更高的退订率。应采用帮助性、价值优先的语气:
邮件1(浏览后2至4小时):聚焦品牌价值、客户评价或与浏览产品类别相关的顶级购买指南。保持语气委婉且不具侵扰性。
邮件2(浏览后24至48小时):分享社交证明、用户生成内容(UGC)亮点,或解答关于运输和退货的常见问题。
有关在您的电子邮件堆栈中配置自动触发的详细说明,请参阅本技术指南,了解Klaviyo集成。
步骤3:通过付费社交受众实现全渠道激活
电子邮件推广只是有效身份解析策略的一部分。通过身份解析捕获的哈希电子邮件(HEMs)也可直接同步至Meta自定义受众和TikTok受众细分API。
将解析出的高意向会话直接同步至付费社交广告账户,使您无需依赖第三方Cookie即可运行低CAC重定向广告。由于社交广告平台内部匹配哈希标识符,付费社交重定向不存在域名送达风险,是重新激活未订阅购物者的理想渠道。
评估供应商工具:计算真实投资回报率
选择软件时,商家应超越表面上的匹配率。声称“75%匹配率”的供应商可能仅提供低质量的概率性家庭数据,损害电子邮件送达率。
为选择合适的访客识别软件,店主应基于净收入影响而非原始匹配量评估工具。
净回收收入公式
要衡量身份解析供应商的真实财务影响,请计算每1000名未识别访客的净回收收入:
$$\text{净回收收入} = \frac{\text{总回收收入} - (\text{软件订阅费用} + \text{验证费用})}{\text{未识别访客总数} / 1,000}$$
访客识别平台对比
评估标准 | 传统客户端识别工具 | 第一方身份解析平台 |
|---|---|---|
跟踪架构 | 客户端JavaScript像素 | 自定义CNAME DNS代理及服务器端API跟踪 |
匹配方法 | 通常依赖概率性家庭匹配 | 个人级确定性图谱匹配(HEMs / MAIDs) |
广告拦截器抗性 | 低(常被现代浏览器阻断) | 高(在原生第一方域上下文中运行) |
ESP保护工具 | 基础选择退出选项 | 内置电子邮件验证、域名预热及自动抑制 |
归因集成 | 与获取报告脱节 | 集成多触点归因及会话跟踪 |
| 监管 / 指标 | 我们框架(CCPA 合规 / CPRA 合规 / 能垃圾邮件) | 欧盟框架(GDPR 合规 / ePrivacy Directive) |
|---|---|---|
| 主要的法律机制 | 撤回同意模型("Notice 和清晰的 choice 到出去") | 严格的授权同意模型("之前明确的授权要求的") |
| 第一方脚本 Loading | Permitted 通过默认提供了清晰的隐私 notices 是展示. | Non-关键的追踪脚本必须仍然是被屏蔽的之前到用户授权. |
| 邮件外呼触达规则 | Commercial 外呼触达是 permitted 如果能垃圾邮件要求和退订链接是遵守. | Commercial 营销邮件要求明确的之前授权之下文章 6. |
| 消费者 Rights | 要求 functional "做不或共享我的"链接. | Mandatory 合适的到是-forgotten erasure 和完整的数据 access rights. |
| 评估标准 | 旧客户端端识别工具 | 第一方身份识别与还原平台 |
|---|---|---|
| 追踪架构 | 客户端端 JavaScript 像素 | 自定义 CNAME DNS 代理 & 服务器端 API 追踪 |
| 匹配 Methodology | 往往依赖概率性 household 匹配 | 用户水平确定性图谱匹配 (HEMs / MAIDs) |
| 广告-Blocker Resilience | 低的(经常被屏蔽的通过现代浏览器) | 高的(运营之内原生的第一方域名 context) |
| ESP 保护工具 | 基础版撤回同意选项 | 内置的邮件 verification, 域名 warming, 和 auto-屏蔽 |
| 归因集成 | Disconnected 从获客报表 | 已集成多触控归因和会话追踪 |
来源与扩展阅读
关于 Attribuly
Attribuly 帮助 DTC 品牌挽回弃购收入。我们识别被你的 ESP(如 Klaviyo)遗漏的匿名访客和已有订阅者,补全他们的画像,并将这些信号回传,让你的弃购流程正常触发、再营销受众持续增长,并帮助你至少多挽回 15% 的收入。 Shopify Featured App,Klaviyo 技术合作伙伴。已获 20,000+ 品牌信任。保证 4× ROI。