如何识别网站访客:一步步技术指南
了解如何识别匿名的网站访客利用反向 IP 查询,服务器端追踪,和身份图谱虽然维护 GDPR 合规.
相关文章
要点
- 要选择合适的识别技术栈,您必须首先区分账户级别识别(B2B)和个人购物者去匿名化(B2C/电子商务)。
- B2B访客识别侧重于识别访问您网站的公司,而非具体个人。
- 在电子商务中,识别企业域名毫无用处;您需要了解个人购物者的身份以恢复放弃的会话。
- 为了构建可靠的访客识别框架,分析工程师结合了四种不同的数据捕获机制。
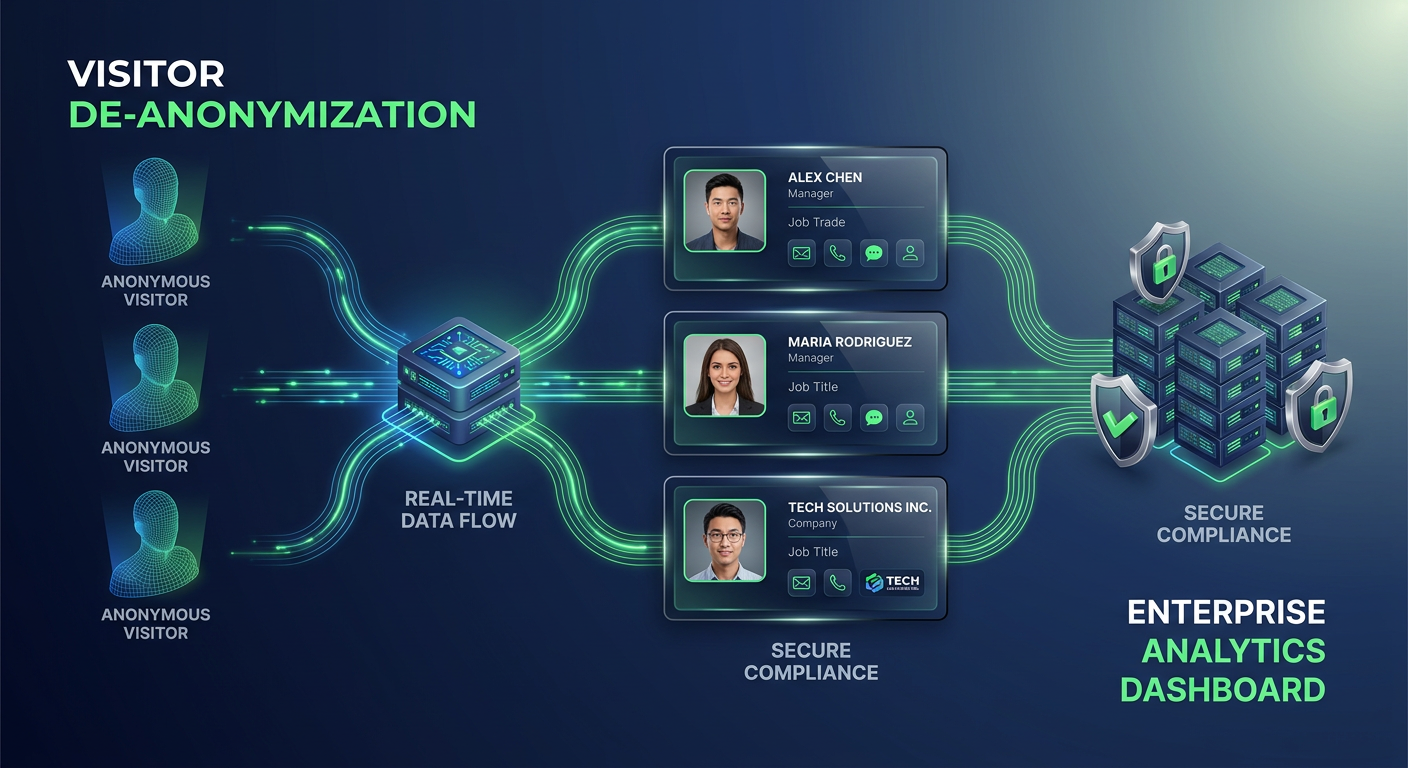
超过95%的网站访客以匿名方式浏览,且未填写表单或完成购买即离开。对于增长营销人员、收入运营负责人和电商创始人来说,这部分未被捕获的流量意味着广告支出的浪费和潜在销售机会的流失。
学会识别网站访客,能够将原始匿名流量转化为可操作的数据。现代访客识别技术使得去匿名化入站网页会话成为可能,揭示账户级或个人意图,并实时触发针对性工作流。
然而,访客去匿名化并非一刀切的过程。识别B2B SaaS网站上的企业买家,需要完全不同的技术和合规标准,与识别直接面向消费者(DTC)商店中的购物者截然不同。本指南详细解析核心识别架构、浏览器隐私防护措施、法规合规规则及逐步设置流程,助您合法有效地去匿名化网站流量。
技术架构:B2B与电商识别对比
选择合适的识别技术栈,首先需区分账户级识别(B2B)与个人购物者去匿名化(B2C/电商)。
                        入站匿名流量
                                    │
        ┌───────────────────────────┴───────────────────────────┐
        ▼                                                       ▼
B2B账户识别                                          电商识别
(反向IP与ASN匹配)                                  (第一方身份图谱)
        │                                                       │
        ▼                                                       ▼
解析对象:企业实体                                  解析对象:个人购物者档案
关键数据:公司画像与意图                            关键数据:哈希邮箱(HEM)与事件历史
目标:销售外呼与账户广告                              目标:ESP流程(Klaviyo)与Meta CAPI
B2B账户识别:反向IP与ASN匹配
B2B访客识别侧重于识别访问您网站的公司,而非具体个人。当用户加载页面时,其浏览器会发送一个源自与自治系统编号(ASN)关联的互联网协议(IP)地址的HTTP请求。
识别引擎捕获该原始IP地址,并与WHOIS注册信息、区域互联网注册机构(ARIN、RIPE)及映射静态IP块至企业网络的公司画像数据库交叉比对。引擎剔除商业互联网服务提供商(如Comcast或AT&T)及云基础设施节点(如AWS或Cloudflare),以隔离企业网络。输出结果为包含公司名称、行业、员工数、年收入及总部所在地的公司画像。
主要应用场景:基于账户的B2B营销(ABM)、实时销售开发代表(SDR)提醒及高意向账户路由。
匹配率基准:B2B流量匹配率预期在15%至35%之间。远程办公、家庭ISP及企业VPN的普及导致剩余流量无法映射。
电商识别:第一方身份解析网络
在电商领域,识别企业域名毫无意义;您需要了解个人购物者身份以恢复遗弃会话。电商购物者去匿名化依赖第一方身份解析图谱。
当匿名用户访问您的商店时,JavaScript标签和服务器端点会收集持久的第一方标识符、设备信号及会话参数(如gclid、fbclid)。若该用户此前已通过购买、订阅新闻通讯或登录联盟合作网站等方式加入身份网络,其身份将以加密安全的SHA-256哈希邮箱(HEM)形式存储。
解析网络将传入的匿名会话令牌与其去中心化身份图谱匹配。若匹配成功,匿名会话将与持久客户档案拼接,揭示其邮箱地址、过往浏览历史及遗弃购物车商品。
主要应用场景:触发浏览/购物车恢复邮件,同步自定义受众进行广告重定向,衡量多触点归因。
匹配率基准:美国国内电商流量匹配率介于20%至50%,具体取决于底层身份网络的覆盖范围。
识别匿名网站访客的核心方法
构建可靠的访客识别框架,分析工程师结合四种不同的数据捕获机制。
1. 反向IP解析
反向IP查询仍是B2B潜在客户发现的基石。通过评估入站IP包与静态企业子网的匹配,工具能即时通知收入团队战略目标账户访问了高价值页面(如定价或安全文档)。
尽管远程办公降低了纯IP查询的准确性,现代引擎通过结合IP数据与次级浏览器信号及历史CRM活动来缓解此问题。
2. 第一方Cookie与服务器端追踪
通过浏览器JavaScript创建的客户端Cookie(document.cookie)日益不可靠。主流浏览器为保护用户隐私限制追踪时长:
Safari智能追踪防护(ITP):将客户端JavaScript Cookie寿命限制为7天,若用户通过含URL追踪参数的广告链接访问,则仅24小时。
Firefox增强追踪保护(ETP):彻底阻止第三方追踪脚本,并隔离跨站点域的存储访问。
广告拦截器:拦截并阻止发送至已知分析域的客户端请求签名。
为维持持久访客识别,组织部署服务器端追踪。通过将事件流路由至同站第一方子域(如ss.yourstore.com),追踪Cookie直接由HTTP Set-Cookie响应头发出,绕过客户端JavaScript限制,保持完整预期时长。
3. 第一方身份解析图谱
身份图谱结合确定性与概率性匹配方法:
确定性匹配:当用户执行直接识别操作时发生——如结账时输入邮箱、提交联系表单或点击邮件活动中的认证链接。系统以100%精度将原始个人身份信息(PII)关联至持久的HEM和会话ID。
概率性匹配:在缺乏确定性关键字时,利用机器学习算法分析上下文信号(IP子网、设备硬件特征、时间戳接近度及浏览器配置)推断身份。
4. 表单提交与事件采集
解析匿名历史的最简单方法是捕获转化事件。当访问您网站五次的匿名访客最终提交潜在客户表单或下载电子书时,您的营销自动化平台将其历史匿名会话ID与新建联系人记录关联,揭示转化前的完整历史触点路径。
隐私与法规合规规则导航
去匿名化网站访客需严格遵守全球数据隐私法规。未能建立明确合法依据可能导致重大监管处罚。
监管框架 | 目标数据类型 | 主要合法要求 | 强制合规措施 |
|---|---|---|---|
GDPR (欧盟及英国) | B2B企业IP数据 | 合法利益 (第6条第1款f项) | 记录合法利益评估(LIA);最小化IP日志;在隐私政策中提供明确的退出机制。 |
GDPR (欧盟及英国) | 个人PII/购物者数据 | 明确事先同意 (第6条第1款a项) | 在触发个人追踪像素前,通过合规的同意管理平台(CMP)获取用户选择加入的同意。 |
CCPA / CPRA (美国加州) | IP地址、Cookie、标识符 | 通知与选择退出权 | 提供明确的“收集时通知”;展示“禁止出售或共享我的个人信息”链接;原生支持全球隐私控制(GPC)信号。 |
GDPR执行规则
根据欧盟通用数据保护条例,IP地址被视为个人数据。
针对B2B IP查询:您可依赖合法利益处理企业IP地址,前提是您的组织需记录LIA,证明处理不会侵犯个人用户的基本权利。原始IP应在数据库解析后立即进行掩码或截断处理。
针对电商个人去匿名化:存储非必要Cookie或收集哈希个人数据前,必须获得明确同意。且需与任何代表您操作的第三方身份解析供应商签署正式数据处理协议(DPA),符合GDPR第28条规定。
CCPA/CPRA执行规则
加州消费者隐私法广义定义个人信息,包括持久唯一标识符、设备指纹及与家庭关联的浏览历史。
您的网站必须在隐私政策中披露访客识别技术。
必须自动尊重浏览器层面的全球隐私控制(GPC)选择退出信号。当浏览器传递GPC标志时,您的服务器必须停止身份解析,并将用户排除在第三方数据共享之外。
步骤1:部署基础标签与服务器端端点
部署识别标签需配置客户端与服务器端基础设施。
客户端部署(一级):将访客识别脚本添加至网站
<head>标签,或通过Google Tag Manager(GTM)在所有页面触发。服务器端代理设置(二级/三级):搭建托管于自定义子域(如
ss.yourdomain.com)的服务器端GTM(sGTM)容器。在DNS设置中创建CNAME记录,将该子域指向您的追踪服务器集群。
类型:CNAME
主机:ss
值:tracking-server.yourdomain.com
TTL:自动
此举确保追踪请求源自您的根域名空间,维护第一方Cookie上下文,规避浏览器存储限制。
步骤2:配置流量采集与机器人排除过滤器
为保护数据库健康及广告预算效率,配置过滤规则剔除非合格会话流量:
内部IP过滤:排除企业总部IP范围、员工子网及远程团队VPN端点。
云基础设施过滤:屏蔽属于AWS、Google Cloud、Azure及Cloudflare的数据中心IP块,排除网络爬虫及自动化机器人。
意图阈值过滤:要求最低参与度阈值(如至少2次页面浏览或超过30秒停留时间)后,才将会话标记为合格潜在客户。
步骤3:实施身份解析与服务器端事件同步
建立跨用户会话的持久标识符解析。
对于希望扩大购物车恢复的电商品牌,工具需处理服务器端事件,并将匿名回访流量拼接回已知档案。例如,Attribuly结合服务器端追踪端点与第一方身份网络,实现回访购物者去匿名化,捕获会话事件流,并在Safari ITP重置客户端Cookie时,仍能将浏览器ID与客户邮箱哈希拼接。
解析完成后,会话数据将附加过往触点元数据,构建端到端客户旅程地图。
步骤4:同步去匿名化数据至CRM与电子邮件营销平台
将去匿名化的意图信号直接发送至下游转化工具。
B2B CRM同步(HubSpot / Salesforce)
将解析出的公司字段(公司名称、行业、收入、访问目标页面)映射至CRM中的账户对象。
配置自动化工作流触发器:当标记为“目标一级”的账户在24小时内两次访问定价页面时,自动向指定客户经理发送任务及Slack通知。
电商ESP同步(Klaviyo)
连接服务器端事件流至您的电子邮件服务提供商(ESP)。
配置动态事件触发器,针对与去匿名购物者邮箱哈希关联的
Viewed Product和Added to Cart事件。根据Klaviyo遗弃购物车设置与恢复的技术文档,实时向ESP自动化流程发送服务器端事件,使店主能在会话遗弃后数分钟内触发个性化恢复邮件,捕获高意向购物者,防止其错失购买窗口。
触发事件:“Viewed Product”(去匿名购物者)
  │
  ├─ 过滤:过去7天内未下单
  ├─ 延迟:30分钟
  │
  └─ 操作:通过ESP流程发送自动浏览遗弃邮件
步骤5:激活多渠道重定向受众
无需依赖第三方追踪Cookie,直接将去匿名化的自定义受众细分流传输至广告平台服务器对服务器API(如Meta Conversions API、TikTok Events API、LinkedIn Matched Audiences)。
通过向广告网络推送验证过的第一方用户参数(email_hash、phone_hash、external_id),您可以无需客户端追踪像素,使用动态广告创意重定向高意向网站访客。
访客识别性能故障排查
监控识别流程时,可能遇到影响数据质量的技术边缘案例。使用此矩阵识别并解决常见性能瓶颈。
                                常见识别瓶颈
                                                │
       ┌────────────────────────────────────────┼────────────────────────────────────────┐
       ▼                                        ▼                                        ▼
匹配率低(<15%)                      云服务商噪声                          会话重复
  ├─ 原因:客户端JS被拦截              ├─ 原因:机器人/爬虫流量              ├─ 原因:跨设备切换
  └─ 解决:启用sGTM CNAME代理          └─ 解决:过滤AWS/Cloudflare ASN         └─ 解决:强制统一UID拼接
1. 匹配率低(<15%)
原因:客户端追踪脚本被广告拦截器拦截,或Safari ITP在回访前清除Cookie。
解决方案:将基础像素安装迁移至使用第一方CNAME DNS映射的服务器端GTM代理。确保通过HTTP头直接设置Cookie的
SameSite=Lax和Secure属性。
2. 云服务商与机器人流量噪声
原因:网络爬虫、运行时间监控及云爬虫导致CRM中出现虚假企业访问(如来源于“Amazon.com”或“Google LLC”的访问)。
解决方案:添加自动ASN过滤规则,屏蔽云基础设施提供商(如AWS ASN 16509、Cloudflare ASN 13335、DigitalOcean ASN 14061)。设置会话参与度过滤,要求访客至少执行一次JavaScript事件交互后,才触发识别丰富。
3. 会话重复计数
原因:用户先后通过5G移动浏览器和桌面Wi-Fi访问网站,产生两个未关联的匿名档案。
解决方案:实施统一的主用户键(
user_id或SHA-256 HEM)。确保分析供应商在用户登录、完成购买或点击含哈希会话参数的个性化邮件链接后,确定性地拼接历史触点。
实施访客去匿名化的下一步
挖掘匿名网站流量的隐藏价值,需将技术执行策略与业务模型相匹配。
审计当前流量画像:确定B2B与DTC/电商访客比例,选择反向IP解析或第一方身份图谱架构。
审查合规立场:确保您的同意管理平台及隐私政策披露明确涵盖GDPR和CCPA下的第一方数据采集。
升级至服务器端追踪:配置第一方DNS子域,绕过浏览器Cookie限制,最大化标识符持久性。
连接自动激活流程:将去匿名化意图信号直接路由至CRM、ESP及广告网络端点,实现潜在客户自动化触达,降低整体获客成本。
欲了解更多关于优化追踪技术栈的信息,请访问我们的基础资源如何识别网站访客与匿名购物者,或查看专门工具Attribuly Capture产品页面。
| 监管框架 | 目标数据 | 主要的 Lawful 要求 | Mandatory 合规动作 |
|---|---|---|---|
| GDPR 合规(欧盟 & 英国) | B2B 企业 IP 数据 | Legitimate Interest (Art. 6(1)(f)) | 文档 Legitimate Interest Assessment (LIA); 最小 IP logs; 提供清晰的撤回同意机制隐私 policy. |
| GDPR 合规(欧盟 & 英国) | 个人信息 / 购物者数据 | 明确的之前授权 (Art. 6(1)()) | Obtain 授权同意授权通过合规授权管理平台(同意管理平台)之前 firing 个人追踪像素. |
| CCPA 合规 / CPRA 合规(California, 我们) | IP 地址, Cookie, 标识符 | Notice & 撤回同意合适的 | 提供明确的"Notice 在集合"; 展示"做不或共享我的个人的信息"链接;遵守全球隐私 Control (GPC) 信号原生地. |
关于 Attribuly
Attribuly 帮助 DTC 品牌挽回弃购收入。我们识别被你的 ESP(如 Klaviyo)遗漏的匿名访客和已有订阅者,补全他们的画像,并将这些信号回传,让你的弃购流程正常触发、再营销受众持续增长,并帮助你至少多挽回 15% 的收入。 Shopify Featured App,Klaviyo 技术合作伙伴。已获 20,000+ 品牌信任。保证 4× ROI。